오늘은 강교수님 딥러닝 수업 마지막 날이다.
벌써 마지막이라니 너무 아쉽다. . .
어제는 모델을 학습시키고 임베딩을 만들었다.
오늘은 LLM 을 내 GPU 에 직접 올려서 말을 시켜보고,
그 LLM 이 거짓말을 못 하게 문서를 붙여주었다.
이 다음 과정은 '머신러닝 모델 서빙과 API 개발 과정'이다.
학습한 모델을 가지고 서빙을 한다고 한다.
1교시  LLM 기초
2교시  로컬 LLM 실행하기
3교시  프롬프트 실무
4교시  LLM 의 한계와 RAG
5교시  RAG1 문서 저장
6교시  RAG2 찾은 내용으로 답하기
7교시  3일 정리 + 보너스 챗봇 화면
Instruct 모델
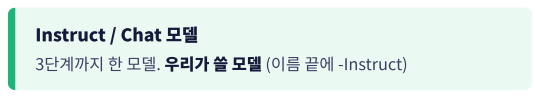
그냥 모델을 쓰는 것보다 Instruct 를 쓰면 더 잘된다고 하셨다.
Q. Instruct 가 더 잘된다는 게 Base 모델보다 잘된다는 뜻일까?
자료를 다시 보니 그런 뜻이 맞는 것 같다.
- Base 모델 : 사전학습(다음 토큰 맞히기)만 한 모델이다. 질문 을 넣으면 질문을 계속 이어 쓰기도 한다.
- Instruct 모델 : 지시 학습과 선호 학습까지 마친 모델. 이름 끝에
-Instruct가 붙는다.
어제부터 쓰던 Qwen/Qwen2.5-1.5B-Instruct 도 끝에 Instruct 가 붙어 있었다.
어제 배운 거 정리

요즘은 temperature 설정이 없어지는 추세라고 한다.
왜냐면 최적의 temperature 설정을 이미 정해놓았기 때문이다.
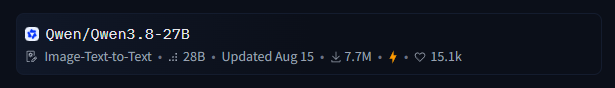
현재 Qwen 2.7B 가 최신이라고 하셨다.
내가 교육이 끝날 쯤엔 2.7B 다음에 뭐가 나올지 궁금하다.
로컬 LLM = 오픈 모델
이제 로컬 LLM 을 직접 실행한다.
proprietary model : 폐쇄된 모델.
On-premise 와 반대되는 개념이 클라우드(AWS, GCP)다.
On-premise 는 내가 내 서버에, 내 DB 에, 모델을 돌리는 것이다.
-> AWS, GCP 에 돈을 내지 않아도 되고, 데이터가 유출될 위험도 없다.
[LLM]            <- 여기에 얹을 수 있는 게 로컬 LLM = 오픈 모델 = 오픈 LLM
[도커 환경 구축] [K8S]
[A100 8장을 구매]
[DB 구축]

-> 이게 MLOps 의 일
이게 정말 중요해 보이는데 헷갈린다. 다시 공부해야겠다.
양자화는 이 한 줄이었다

여기서 양자화는 load_in_4bit 이거를 일컫는 거라고 한다.
어제 마라탕 물어볼 때도 있던 코드인데 그때는 뭔지 모르고 지나갔다.
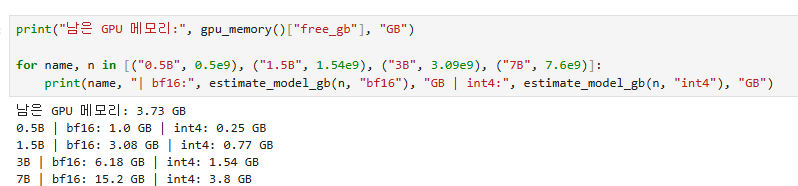
메모리 예상도 해봤다.
토큰 = 비용과 속도의 단위
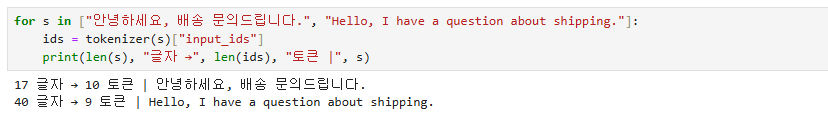
글자 수와 토큰은 큰 의미가 없고, 일반적으로 단어 수로 보면 된다.
유료 API 는 토큰 수로 요금을 매기고, 생성 시간도 토큰 수에 비례합니다.
같은 뜻이라도 언어·모델마다 토큰 수가 다릅니다.
LLM 은 다음 토큰 확률을 for 문으로 돌리는 것
"하루마켓에서 산 옷이 너무" 다음에 뭐가 올지 확률을 그려봤다.
plot_next_tokens(model, tokenizer, "하루마켓에서 산 옷이 너무")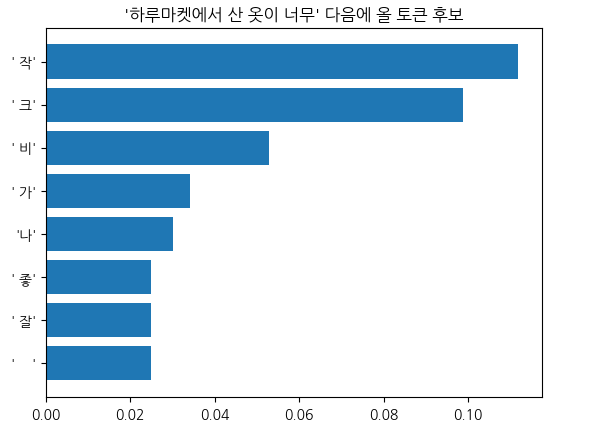
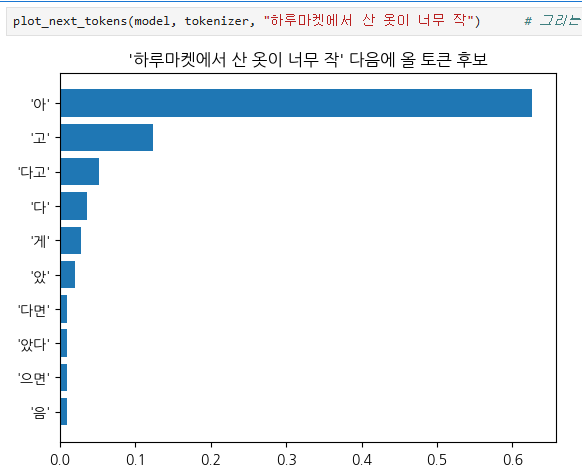
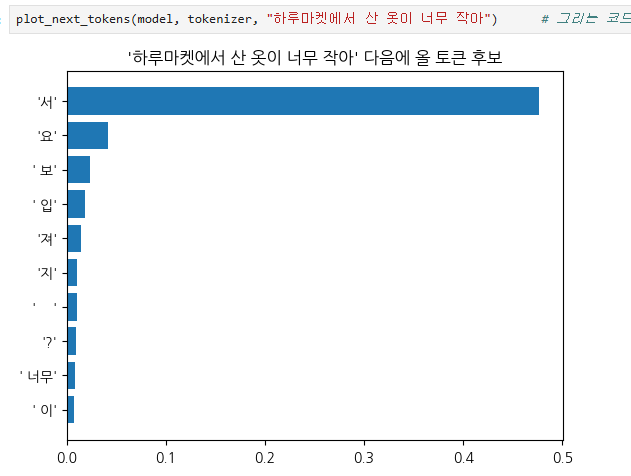
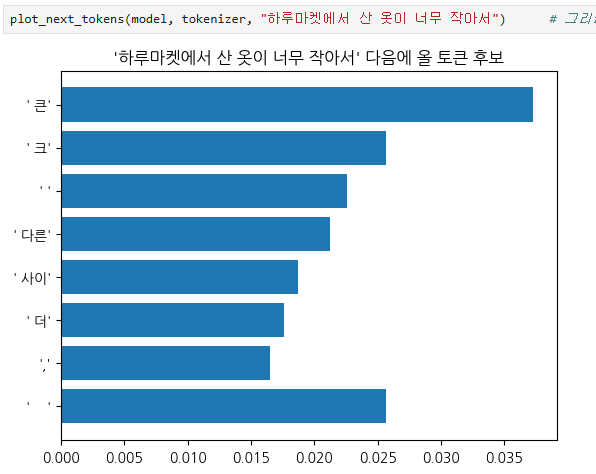
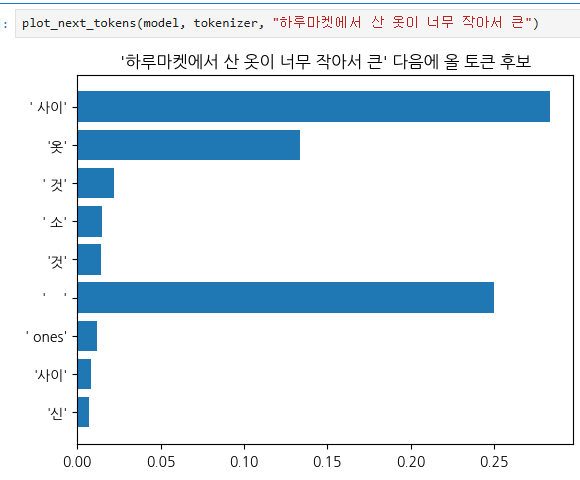
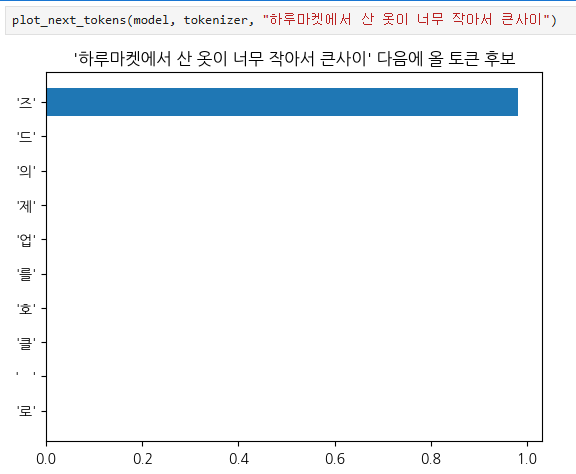
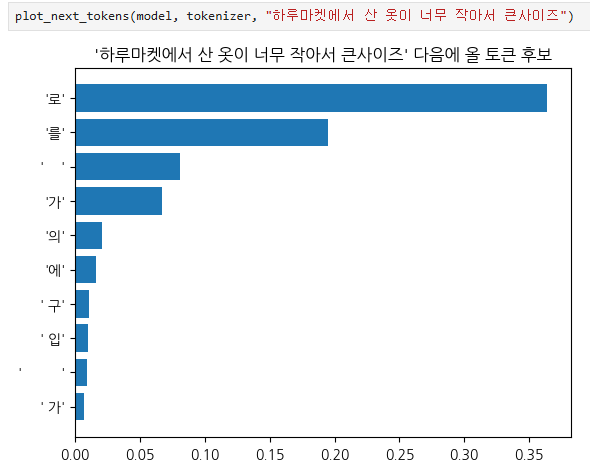
LLM 은 이것을 for 문으로 돌리는 것이다.
실제로 for 문으로 돌리면 이렇게 나온다.
# 한 토큰씩 직접 이어 쓰기 (매번 1등만 고름)
ids = tokenizer("오늘 점심 메뉴로", return_tensors="pt").input_ids.to(model.device)
print("오늘 점심 메뉴로", end="")

for step in range(25):
    with torch.no_grad():
        next_id = model(ids).logits[0, -1].argmax()        # 다음 토큰 중 1등
    ids = torch.cat([ids, next_id.view(1, 1)], dim=1)       # 뒤에 이어 붙이기
    print("|" + tokenizer.decode(next_id), end="")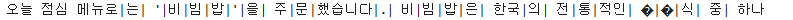
argmax() 로 1등을 고르고, torch.cat 으로 뒤에 붙이고, 다시 1등을 고른다.
25번 돌리니까 문장이 됐다.
결론 : LLM 은 어떤 입력이 들어왔을 때 다음 글자를 잘 예측하도록 transformer 를 잘 구축하고 학습시킨 것이다.
채팅 형식 : system / user / assistant
assistant 는 맥락에 맞게 답해야 할 때 쓴다.
멀티턴 : 물어보고 답하고, 답한 것을 가지고 또 물어보는 것.
LLM 에서는 멀티턴을 잘하기가 어렵다고 한다.
대화가 너무 길어지면 LLM 은 앞의 내용을 요약해서 가져오기 때문에 세부 정보가 빠지는 경우가 많다.
그러므로 요약본을 가지고 새로운 채팅창을 열어서 질문하는 게 낫다고 하셨다.
temperature 를 직접 돌려봤다
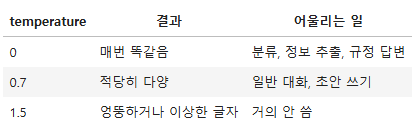
temperature 가 높으면 높을수록 창의적이고 실험적인 값을 내놓는다.
다만 토큰과 시간이 많이 쓰인다.
"하루마켓이라는 쇼핑몰의 광고 문구를 한 줄로 써줘"
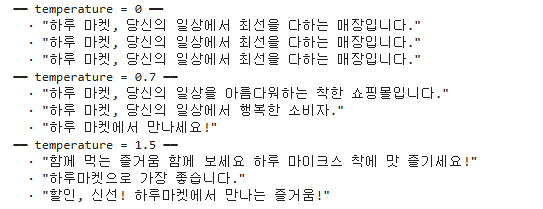
정성평가를 할 때는 temperature 를 0 으로 하고 결과를 낸다.
매번 결과가 달라져선 안 되기 때문이다.
아이디어를 뽑을 때는 temperature 를 높인다.
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)스트리머 : 토큰을 그때그때 만드니까, 예측되는 대로 실시간으로 바로바로 보여주는 것.
ChatGPT 가 글자를 한 자씩 쓰는 게 이거였다.
https://huggingface.co/Qwen/Qwen3.8-27B/tree/main 도 잠깐 들어가 봤다.
보캡 . . ?? 이라는 말이 나왔는데 정확하게 뭐하는건지 잘 모르겠다.
모델을 잘 쓰기 위한 방식 : 프롬프트
맥락상에서 다음 토큰을 예측하기 때문에 명령이 중요할 수밖에 없다.
잘못된 질문을 해서 잘못된 답변을 받았을 때는 노이즈가 꼈기 때문에 그냥 초기화하는 게 낫다.
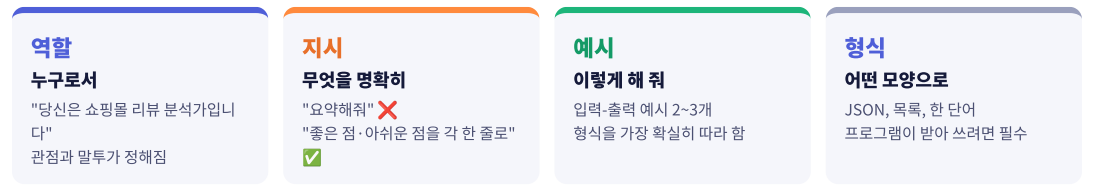
모델이 이런 조건(SDO 인지 PPO 인지, 정확히 못 받아적었다)을 갖췄기 때문에 우리가 이렇게 질문을 해야 한다.
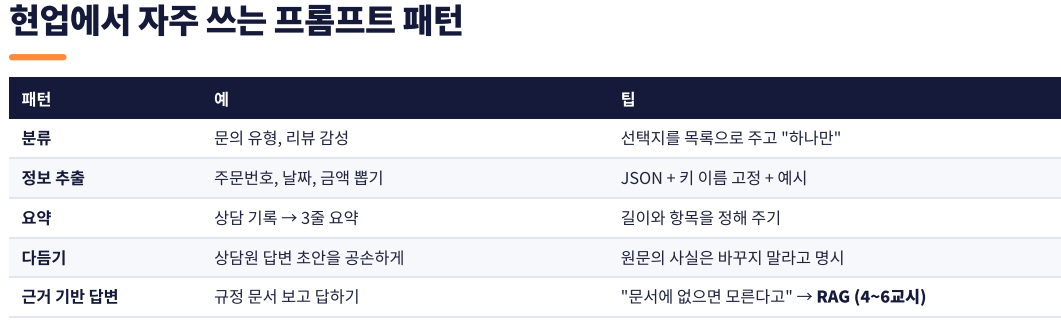
역할, 지시, 예시, 형식. 네 가지다.
- 역할 : LLM 에게 페르소나(가상의 인격체)를 줘야 한다.
- 지시 : 명확하게 지시. ex> 포인트 세 개를 잡아줘.
- 예시 : few-shot, zero-shot. 사례 0개 zero-shot, 1개 one-shot, 여러 개 few-shot.
- 형식 : 앞뒤 미사여구 없이 프로그램이 받으려는 형식.
아마 지금까지 나는 제로샷으로 지시를 했을 것이다.
"요약을 한 문단으로 해. 그 예시는 이거야." 이렇게 준 적이 없다.
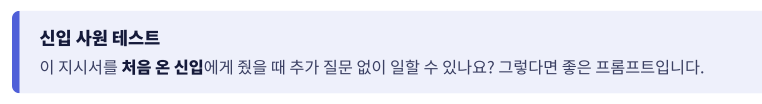
이 얘기를 들으면서 교수님께서 하신 말씀이다.
우리는 이제 학생들에게 개발팀장의 역할을 가르쳐야 하지 않을까?
AI 가 이렇게 발전했으니 개발을 가르치는 게 아니고, 개발을 잘 시키기 위해서 개발자의 보스 역할을 가르쳐야 한다.
신입이 이해할 수 있게 정보를 담아서 프롬프팅을 해야 한다.
하다못해 좋은 프롬프트를 나오게 하는 모델도 있다고 한다. 충격적이다.
few-shot 은 적당히
제로샷보다는 예시를 주는 게 좋다.
예시가 너무 많으면 앞의 표현, 답변 등을 그대로 따라가는 부작용이 생길 수 있다.
일반성을 잃어버리기 때문에 적당히 주어야 한다.
그 적당히는 실험적으로 그때그때 찾아봐야 한다고 하셨다.

문서에 없으면 모른다고 하라.
혹은 내가 물어본 것에 답을 하게 된 근거를 말해라.
{
  답 : {},
  근거 : {}
}
근거에 말도 안 되는 게 있으면 버려라, 혹은 다시 테스트를 하라.
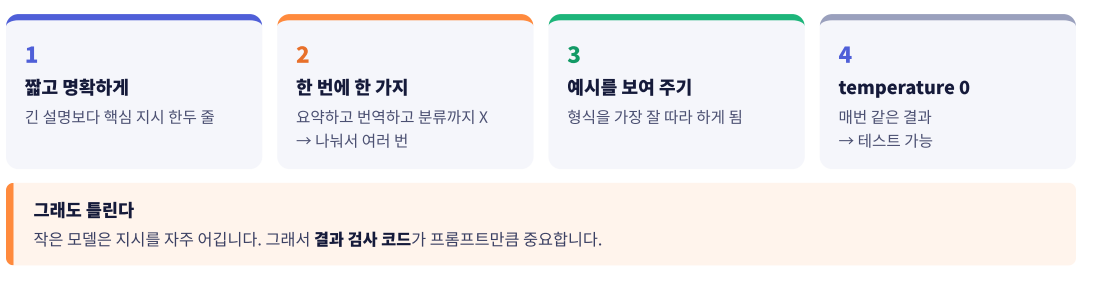
큰 모델은 잘하는데 작은 모델은 제한적이다.
나쁜 프롬프트 vs 좋은 프롬프트
review = ("이번에 원피스를 샀는데 색은 사진이랑 거의 같고 예뻐요. 근데 배송이 5일이나 걸렸고 "
          "상자가 찌그러져서 왔어요. 사이즈는 평소 입는 M 샀는데 조금 작아요. 가격 생각하면 그럭저럭 만족합니다.")

bad = "요약해줘 " + review

good = f"""당신은 쇼핑몰 리뷰 분석가입니다.
아래 리뷰를 읽고 다음 형식으로만 답하세요.
- 좋은 점: (한 줄)
- 아쉬운 점: (한 줄)
- 전체 평가: 긍정/부정/중립 중 하나

리뷰: {review}"""

print("━━ 나쁜 프롬프트 ━━\n", llm(bad))
print("\n━━ 좋은 프롬프트 ━━\n", llm(good))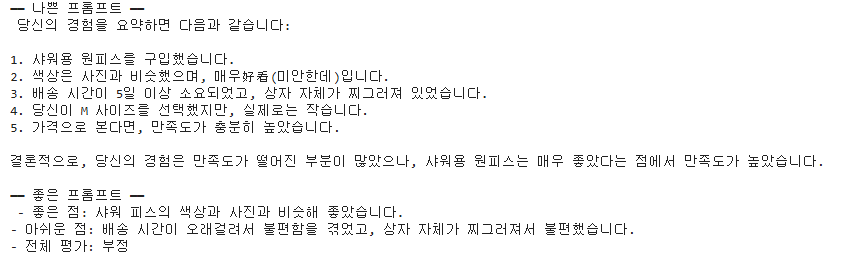
좋은 프롬프트에도 구조가 안 맞는다. 1.5B 라 그런가 보다.
예시 주기(few-shot)로 감성 분류도 해봤다.
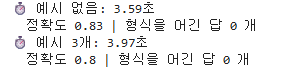
예시가 없는데 더 정확도가 높게 나왔다
원래 예시가 있으면 정확도가 더 높게 나와야하는데 뭔가 잘못됐다.
temperature 를 1.5 로 바꾸면 뭐가 달라질까 싶어서 바꿔봤다.
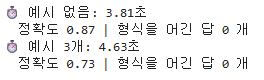
이번에도 예시 있는 쪽의 정확도가 더 낮아졌다.
JSON 출력 형식
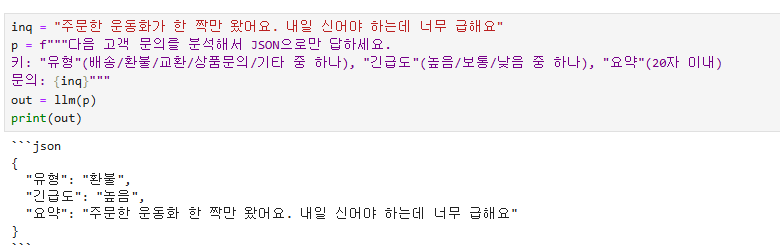
출력 형식을 JSON 으로 정했는데 아래 에러가 났다.
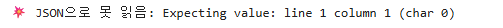
이유는 온전한 JSON 이 아니라 앞뒤에 ```json 이 붙어서 그런 것이다.
LLM 이 답을 코드블록으로 감싸서 돌려줬다.
이럴 경우 실무에서는 코드를 작성해서 ```json 을 제거하기도 한다고 하셨다.
그리고 값이 허용되는 답변인지 아닌지 키를 확인해봐야 한다.
# LLM이 허용되지 않은 값을 쓰면? 예: 유형 "택배" (목록에 없음)
answer = {"유형": "택배", "긴급도": "매우 급함", "요약": "..."}
print("유형 OK?", answer["유형"] in ["배송", "환불", "교환", "상품문의", "기타"])
print("긴급도 OK?", answer["긴급도"] in ["높음", "보통", "낮음"])
in 으로 허용 목록에 있는지만 봐도 걸러진다.
파인튜닝 모델 vs LLM 프롬프트
어제 만든 파인튜닝 모델과 오늘 LLM 을 같은 리뷰로 붙여봤다.
- 파인튜닝 : 정확도 0.92. 속도도 더 빠르다.
- LLM : 정확도 0.85. 대신 처음 보는 일에 대해서도 잘할 수 있다.
이게 옛 버전의 LLM 이라서 파인튜닝이 더 높게 나온 걸 수 있다.
아마 현재의 LLM 을 사용하면 0.99 가 나올 것이라고 하셨다.

환각(hallucination)
LLM 이 거짓말하는 것을 막고, 근거에 맞게 답하도록 만든 게 RAG 다.
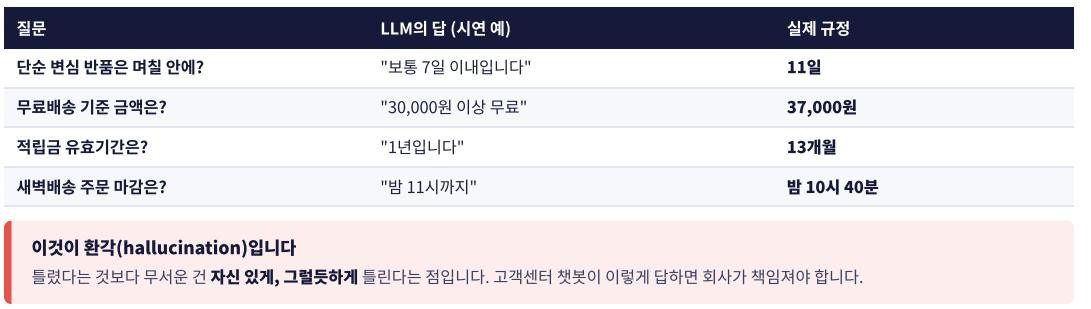
틀렸다는 것보다 무서운 건 자신 있게, 그럴듯하게 틀린다는 점이다.
LLM 은 기존에 학습한 지식 안에서 답을 한다.
진짜 지식을 주입하는 것이 RAG 의 핵심이다.
왜 환각 증세가 있을까?
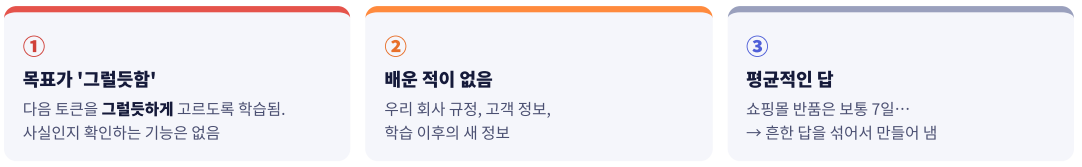
LLM 이 가지고 있는 최신 정보는 최소 6개월 전이다.
학습하는 데 오래 걸리기 때문에 텀은 더 길어진다.
따라서 LLM 에게 지식을 기대하지 말고, 읽고 정리하는 능력을 빌려 써야 한다.
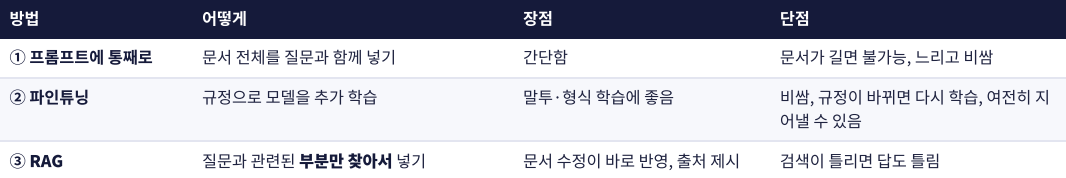
Q (Context) -> LLM -> Ans

User:
  Q: ...
  C: ...     <- LLM 이 참고해야 할 정보 (Context)
평가 세 가지 : IR 평가, SYSTEM 평가, LLM 평가
추후에는 LLM 만 평가하는 게 아니라 IR 의 성능도 평가한다.
서비스를 평가할 때 필요한 것 : 골드페이지(gold page, 정답이 있는 페이지), 정답지.
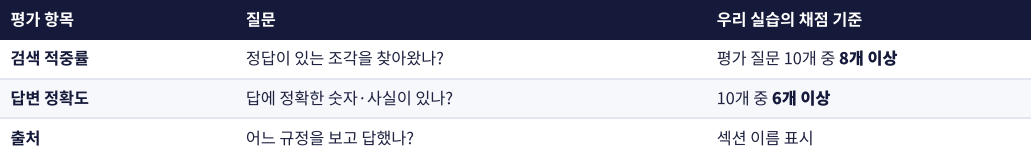
- IR 평가(검색 평가) : IR 을 했을 때 나오는 결과에 내가 필요로 하는 골드페이지가 들어가 있는지 확인한다.
- LLM 평가 : IR 에 골드페이지를 넣고 LLM 이 잘했는지 못했는지 평가한다.
- SYSTEM 평가 : IR 에서 나오는 결과를 그대로 LLM 에 넣어서 잘했는지 평가한다. => IR 평가 + LLM 평가
실제 정답지 중에 내가 가지고 있는 것이 얼마나 있느냐가 Recall 이다.
검색 적중률은 Recall, 답변 정확도는 답변을 잘 만들었느냐다.
RAG = 오픈북 시험
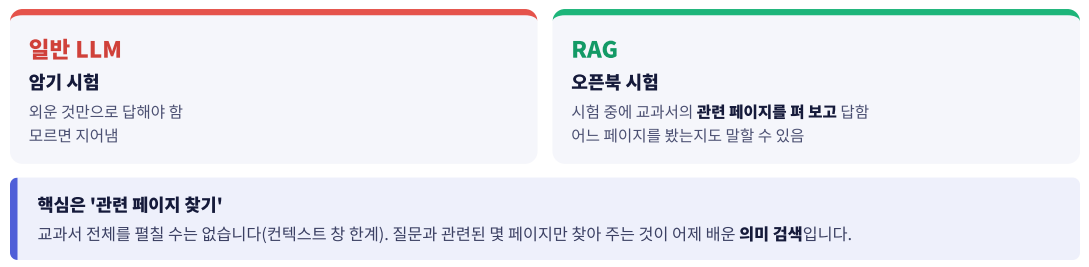
벡터DB : 문서를 임베딩으로 잘 쪼개서 빠르게 저장해놓을 수 있는 DB이다.
색이 빠르기 때문에 쓴다.
페이지 단위가 아니고 의미 있는 단위(섹션)로 쪼갠다.
그 덩어리를 청크(Chunk)라고 부른다.
필요로 하는 정보를 빠짐없이 전달하는 게 목적이다.
청크를 나누는 것도 IR 성능에 영향을 끼친다.
그래서 청크를 나누는 것도 LLM 을 써서 나눈다고 한다.
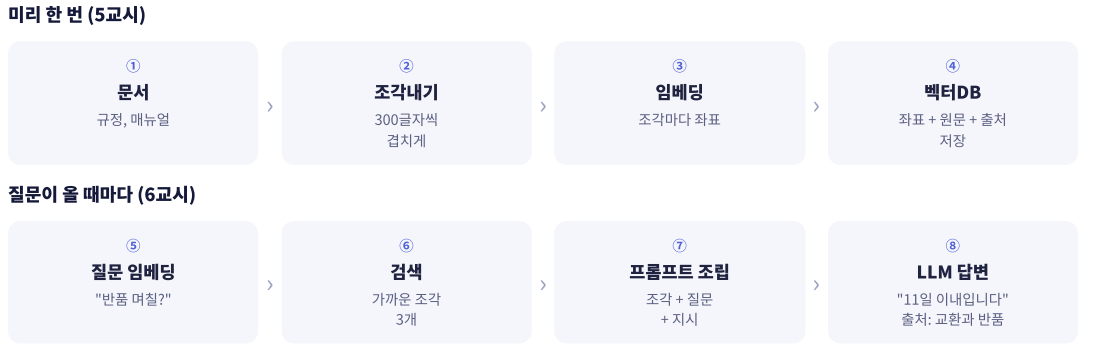
과거에는 사진처럼 규칙 기반으로 했는데, 요즘엔 LLM 을 사용한다.
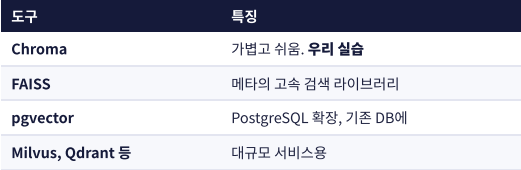
벡터 데이터베이스 종류도 봤다.
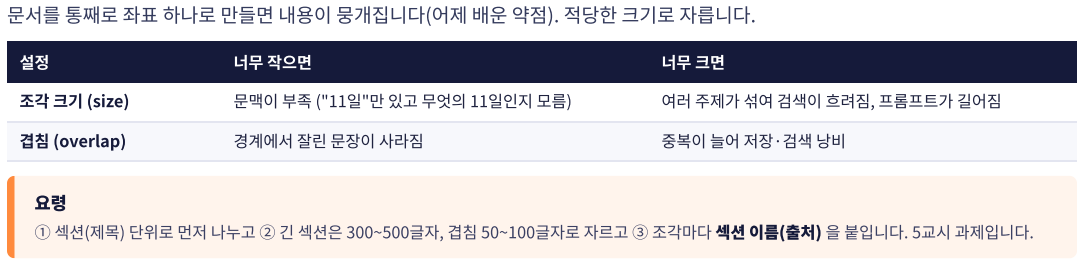
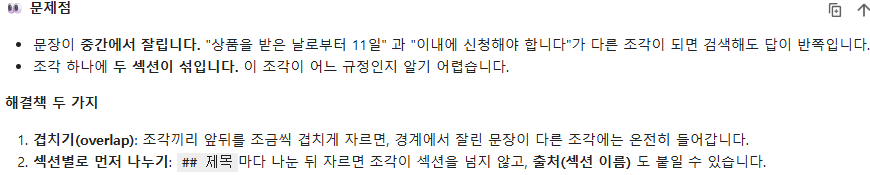
문서를 찾기 좋게 겹치기(overlap)
5교시는 문서를 검색하기 좋게 만들어 놓는 것이다.
그냥 글자 수로 자르면 청크와 청크 사이의 맥락이 끊겨버린다.
이를 해결하는 게 겹치기(overlap)와 섹션별로 먼저 나누기다.
chunker = load_my_module("chunker")      # 내가 만든 chunker.py 불러오기

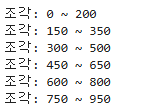
print(chunker.chunk_text("가나다라마바사아자차카타파하", size=5, overlap=2))

chunks = chunker.chunk_by_section(policy, size=300, overlap=50)
print(len(chunks), "조각")
for c in chunks[:4]:
    print("[" + c["section"] + "]", c["text"][:50], "...")
['가나다라마', '라마바사아', '사아자차카', '차카타파하']
13 조각size=5, overlap=2 니까 5글자씩 자르되 앞 조각의 끝 2글자를 다시 붙인다.
'라마' 가 두 번 나오는 게 그거다.
현재 벡터DB 상태 확인해보기

지금은 크로마 벡터DB 를 쓰고 있어서 크로마에 들어가서 확인이 가능하다.
클로드에게 이렇게 시켰다.
> 모델 크로마 DB 경로 '.../models/chroma_policy/chroma.sqlite3' 이고 데이터가 저장되어 있어.
  저장되어 있는 데이터를 보는 코드를 show_db.py 에 작성해줘.
현재 벡터DB 상태가 궁금했는데 이렇게 확인해볼 수 있다고 한다.
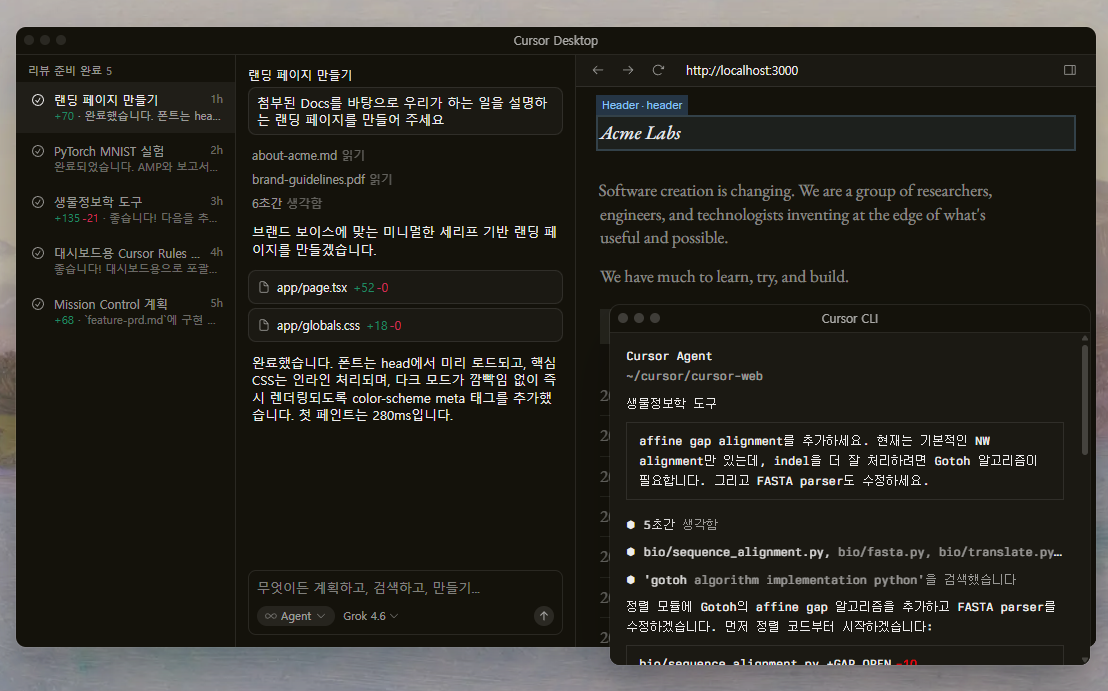
Q. vscode 안에 클로드 코드가 들어온 지 얼마나 됐을까?
cursor 가 생기고 시작됐다고 한다. 아마 작년 10월부터.
실제로 에이전트로 사용된 것은 5개월 정도 됐다고 하셨다.
cursor 는 테슬라가 어마어마한 돈을 주고 샀다고 한다.https://cursor.com/ko/home
Q. 벡터DB 와 ORACLE, MSSQL 같은 DB 는 어떤 차이가 있을까? redis 같은 가벼운 DB 일까?
redis 는 인메모리고 한 번에 싹 올리는 것이다.
껐다가 켜면 사라진다고 한다.
벡터DB 를 보는 툴이 있는지도 물어봤는데 -> 모르겠다고 하셨다. 잘 안 쓰나 보다.
DB 별로 읽는 게 빠른 게 있고 쓰는 게 빠른 애들이 있다.
- 쓰는(적는) 게 빠른 애들 : 예를 들어 네비게이션
- 읽는 게 빠른 애들 : 예를 들어 편의점 포스기
RAG 없이 물어보면 환각
import json
evalq = json.load(open(RAG_EVAL_FILE, encoding="utf-8"))     # 평가용 질문 10개 (정답 숫자 포함)

for q in evalq[:4]:
    answer = chat(tokenizer, model, q["question"], system="당신은 하루마켓 고객센터 상담원입니다.",
                  temperature=0, max_new_tokens=80)
    print("질문:", q["question"])
    print("LLM :", answer)
    print("(규정의 정답에는 '" + q["keyword"] + "'가 들어가야 함)\n")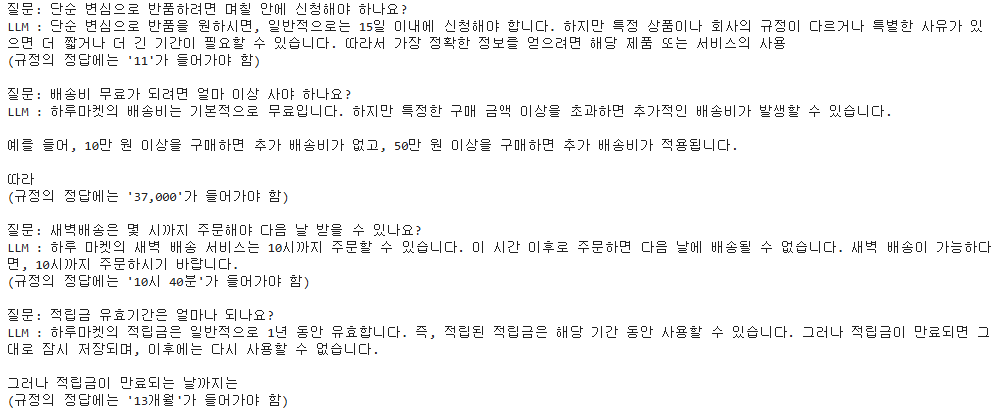
하루마켓 규정을 본 적도 없는데 자신 있게 답한다.
청크 3개 찾아서 프롬프트에 넣기
embedder 로 가장 흡사한 청크 3개를 가져온다.

이 세 개가 가장 가까운 청크다.
이렇게 청크를 찾는 것까지가 IR 이다.
그다음 프롬프트를 만든다. 이건 LLM 에게 보낼 명령이다.
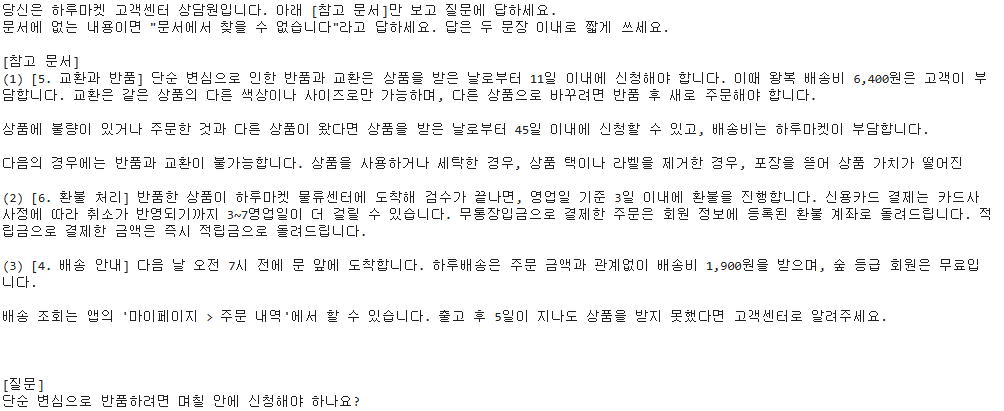
답을 하는 데 필요하지 않은 것이 들어 있을 수 있다.
그러나 LLM 에게 필요한 정보가 빠지지만 않으면 되지, 정보가 과도한 것은 전혀 문제가 되지 않는다고 하셨다.
지금은 예시로 청크를 3개 정도만 주는데 최근 LLM 에서는 16개 정도를 준다고 한다.
요즘 LLM 이 출처를 마지막에 붙여주는데, 그것이 LLM 이 참고한 페이지다.
프롬프트를 입력해서 답을 받아오는 것까지가 RAG 다.
문서에 없는 질문이 나올 경우
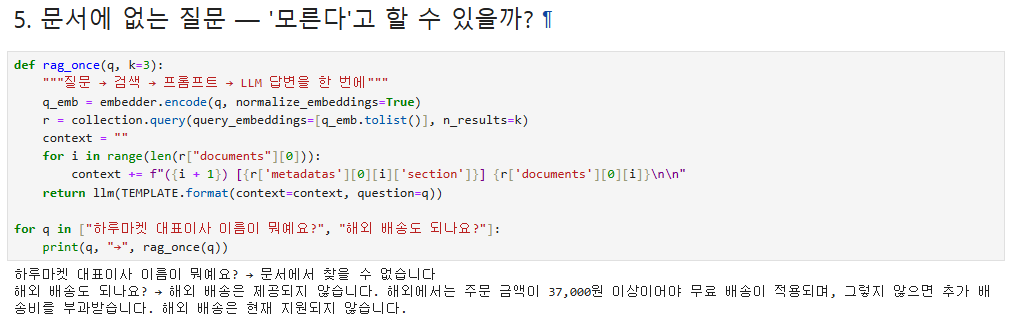
문서에서 찾을 수 없다는 결과가 나온다.
근데 재미있는 게, "해외 배송은 제공되지 않습니다. 해외에서는 주문 금액이 37,000원 이상이어야 무료 배송이 적용된다"는 결과가 나왔다.
안 된다면서 조건을 붙인다.
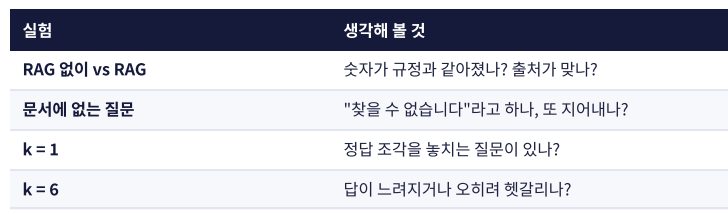
청크를 몇 조각 넣는 게 좋을까?
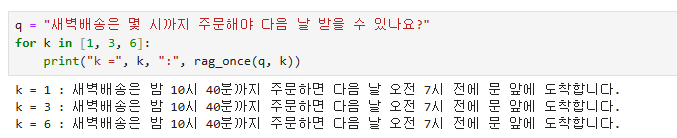
청크가 너무 많으면 프롬프트가 길어져 느려지고 메모리도 더 든다.
청크가 많아진다고 성능이 좋아지는 건 아니다.
k 가 많아지면 헷갈려 하진 않고 답이 느려진다.
RAG 는 과거의 산물이 되었다
이제는 In-document QA 라고 부른다고 하셨다.
Q. 최근에는 In-document QA 라고 부른다는데, 코드 안에서는 rag 라고 그대로 쓸까?
그대로 사용된다.
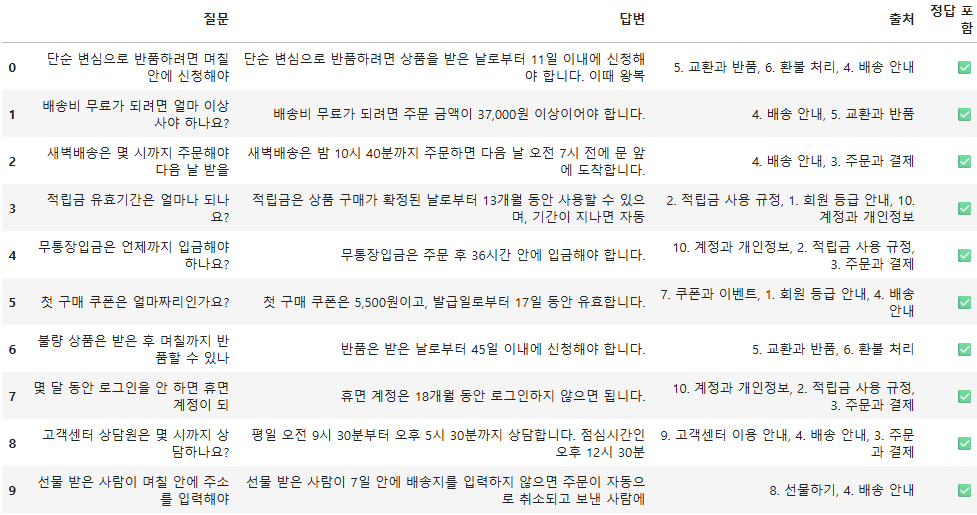
r = rag.answer(q["question"], collection, embedder, llm)이름만 바뀌었지 하는 일은 같다.
import pandas as pd
rag = load_my_module("rag")      # 내가 만든 rag.py 불러오기

rows = []
for q in evalq:
    r = rag.answer(q["question"], collection, embedder, llm)
    if q["keyword"] in r["answer"]:
        ok = "O"
    else:
        ok = "X"
    rows.append({"질문": q["question"][:25], "답변": r["answer"][:50], "출처": ", ".join(r["sources"]), "정답 포함": ok})

pd.set_option("display.max_colwidth", 60)
pd.DataFrame(rows)
In-document QA 를 써서 모듈을 돌려봤더니 성능이 좋게 나왔다.
지금까지 AX 시스템을 만들어본 것이다.
In-document QA 가 있을 때와 없을 때의 차이가 확실히 있다.
3일 정리
앞의 3일은 딥러닝, 뒤의 3일은 GPU 위에 모델을 올려서 돌려봤다.
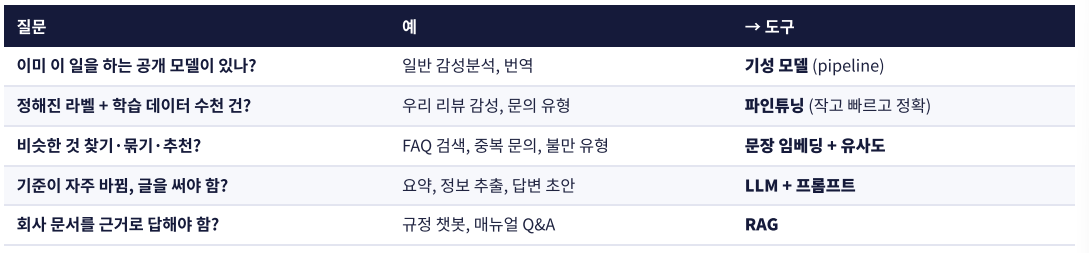
상황별 도구 선택표를 봤다.
냉혹한 현업에서 이어지는 주제들.
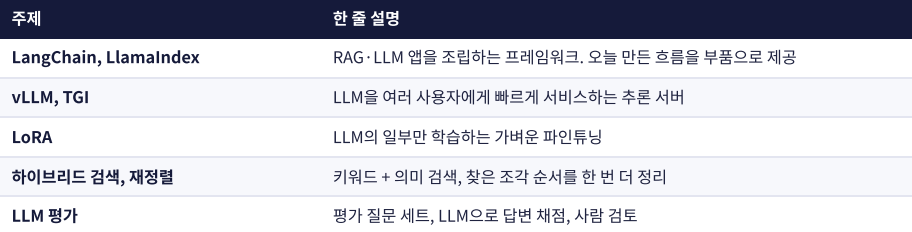
- LangChain : LLM 과 소통할 때 멀티턴을 도와준다
- vLLM : LLM 을 VLM 에 올려준다
- LoRA : LLM 성능 튜닝
- 하이브리드 검색, 재정렬 : IR 검색을 도와준다
- LLM 평가 : 정성평가 기준
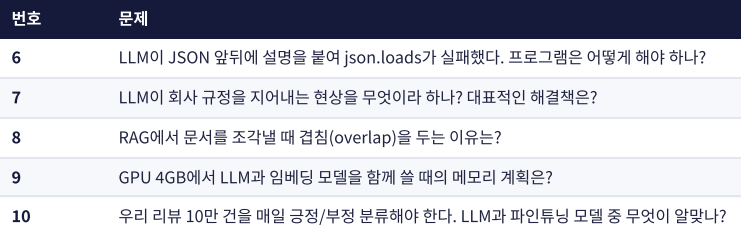
복습 문제
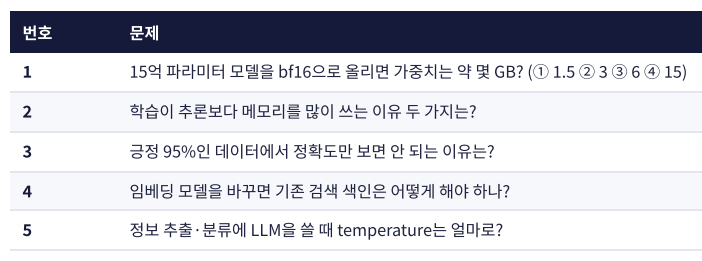
2. 학습이 추론보다 메모리를 많이 쓰는 이유 두 가지는?
   : 기울기를 적용하기 때문이다.
3. 긍정 95% 인 데이터에서 정확도만 보면 안 되는 이유는?
   : 과적합일 경우가 있다. 정확도보다 정밀도를 중요시 여겨야 한다. f1 을 함께 봐야 한다.
4. 임베딩 모델을 바꾸면 기존 검색 색인은 어떻게 해야 하나?
   : 색인을 새로 만들어야 한다.
5. 정보 추출·분류에 LLM 을 쓸 때 temperature 는 얼마로?
   : 낮게.
6. LLM 이 JSON 앞뒤에 설명을 붙여 json.loads 가 실패했다. 프로그램은 어떻게 해야 하나?
   : 설명을 제거하는 Python 코드를 작성한다.
7. LLM 이 회사 규정을 지어내는 현상은? 대표적인 해결책은?
   : 환각. RAG 를 사용한다.
8. RAG 에서 문서를 조각낼 때 겹침(overlap)을 두는 이유는?
   : 앞 문서의 내용이 현재 섹션과 이어져 있을 경우를 염두에 두고.
9. GPU 4GB 에서 LLM 과 임베딩 모델을 함께 쓸 때의 메모리 계획은?
   : LLM 은 GPU, 임베딩은 CPU.
10. 리뷰 10만 건을 매일 긍정/부정 분류해야 한다. LLM 과 파인튜닝 모델 중 무엇이 알맞나?
   : 파인튜닝.
Q. 2번은 역전파랑 관계있을까?
기울기를 적용하기 때문이라고 답했는데, 그 기울기가 역전파에서 나오는 건지 잘 모르겠다.
청크별로 임베딩하는 것은 서비스 시간이 아닌 시간에 하기 때문에 시간이 오래 걸려도 괜찮다고 하셨다.
9번이랑 이어지는 얘기다. 임베딩은 CPU 에 둬도 된다.
보너스 : gradio 로 챗봇 화면
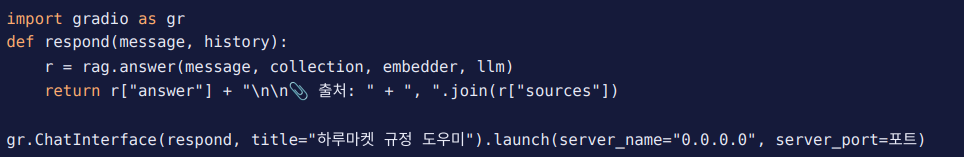
gradio 는 AI 로 학습된 것을 웹으로 데모를 돌려서 결과를 볼 수 있게 해준다.
챗봇까지 준비해두고 "해당 코드를 웹 그라디오 버전으로 만들어줘" 라고 LLM 에게 시킨다.
import chromadb
from sentence_transformers import SentenceTransformer

tokenizer, model = load_llm(MODELS["llm"])                  # llm_chat.py (2교시)

def llm(prompt):
    return chat(tokenizer, model, prompt, temperature=0, max_new_tokens=200)

embedder = SentenceTransformer(MODELS["embed"], device="cpu")
collection = chromadb.PersistentClient(path=CHROMA_DIR).get_collection("policy")    # 벡터DB (5교시)

print(answer("반품 기간이 어떻게 돼요?", collection, embedder, llm))     # rag.py (6교시)
show_gpu()
2교시에 만든 llm_chat.py, 5교시 벡터DB, 6교시 rag.py 가 한 셀에 다 모였다.
화면 띄우는 것까지 해봤다.

Q. 모듈과 모델의 차이?
딥러닝 마지막 시간이라서 질의응답 시간을 가졌다.
ML 강의에서 프로젝트를 진행할 때 모델을 하나 만들었는데, 클로드가 자꾸 모델이 아니고 모듈이라고 지칭했다.
이게 궁금해서 질문을 했다.
답변 : 현재 시점에서는 ML 은 모델이 아니고 모듈로 인식이 되기 때문이다.
지금 모델이라고 할 수 있는 것은 AI 모델이다.
6일 동안 텐서부터 시작해서 RAG 챗봇 화면까지 왔다.
아직 모르겠는 게 있다.
로컬 LLM 아래에 도커, K8S, A100, DB 가 깔리는 그림이 MLOps 라는 건 알겠는데, 각각이 어떻게 이어지는지는 헷갈린다. 다시 공부해야겠다.
보캡이 뭔지 못 잡았다. 허깅페이스 파일 목록 보다가 나온 말이다.
복습 문제 2번의 기울기가 역전파랑 같은 얘기인지 모르겠다.
프롬프트 4요소 앞에 붙은 SDO 인지 PPO 인지 하는 이름도 제대로 못 들었다.
다음은 '머신러닝 모델 서빙과 API 개발 과정'이다.